Получение частей коллекции
Иногда нужен не весь список, а только его часть: диапазон элементов, несколько первых или последних элементов, части одинакового размера или скользящее окно из соседних элементов.
Для большинства таких задач в Python есть один синтаксис — срез. words[low:high] даёт элементы от индекса low до индекса high, не включая его. Если не указать low, срез начнётся с начала, а если не указать high, он дойдёт до конца. Отрицательный индекс отсчитывается от конца, а третье число задаёт шаг.
s[low:high]— от индексаlowдоhigh, не включая егоs[:n]— первыеnэлементовs[n:]— всё от индексаnдо концаs[-n:]— последниеnэлементовs[::2]— каждый второй элемент
Срез всегда создаёт новый список и копирует в него выбранные элементы. Изменение копии не меняет исходный список, а изменение исходного списка не меняет копию. В некоторых других языках та же операция даёт представление, которое использует общую память с исходным списком, — в Python так не бывает никогда.
Для задач, которые срез не решает сам по себе, в этом уроке используются функции из модуля itertools и одна-две небольшие вспомогательные функции.
В большинстве примеров на этой странице используются одни и те же данные: слова one two three four five six.
Срез
Срез — это выбор элементов, стоящих на определённых позициях.
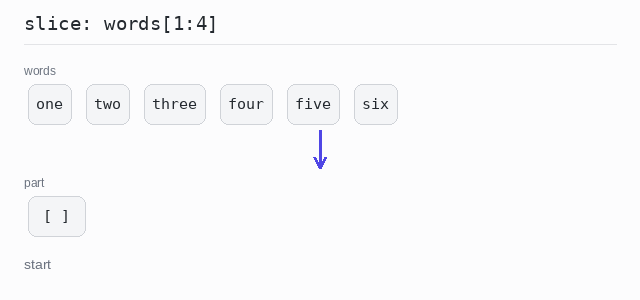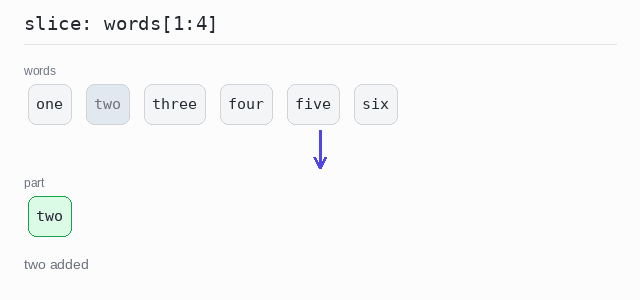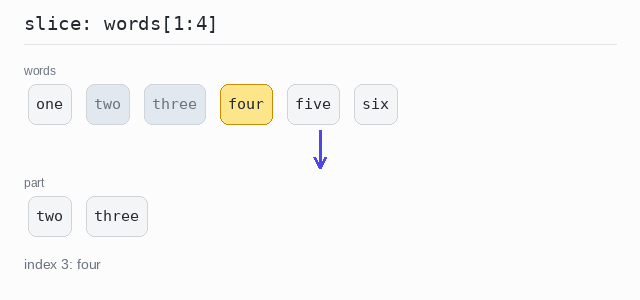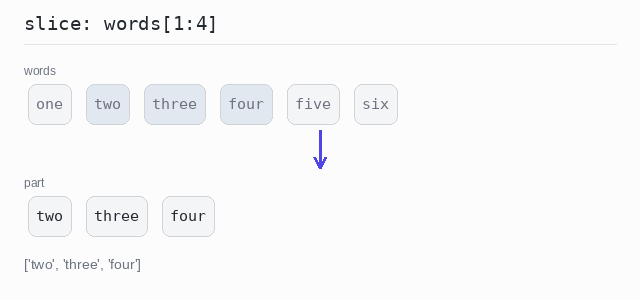
Для ряда соседних позиций используйте срез: words[1:4] даёт элементы с индексами 1, 2 и 3. Помните, что конечный индекс не включается: чтобы получить элементы с индексами от 1 до 3, нужно написать 1:4.
Срез может даже пропускать элементы: третье число — это шаг, поэтому words[::2] берёт каждый второй элемент. Для позиций, которые вы перечисляете сами и в своём порядке, используйте генератор списка по списку индексов.
Срез диапазона
words[1:4] начинается с индекса 1 и останавливается перед индексом 4. В результате 3 элемента: ['two', 'three', 'four']. Это новый список, поэтому его изменение не затронет words.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five", "six"]

# индексы 1, 2 и 3 - конечный индекс 4 не включается
part = words[1:4]

print(part)
Срез с шагом
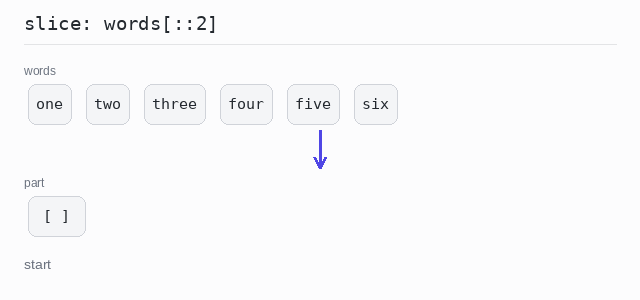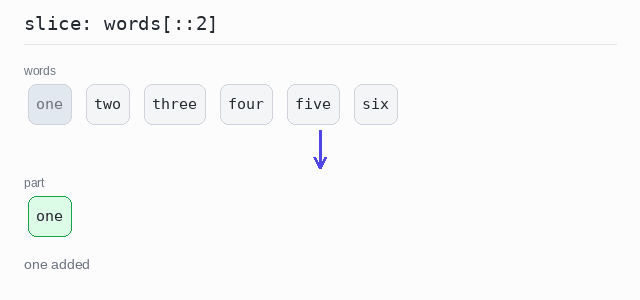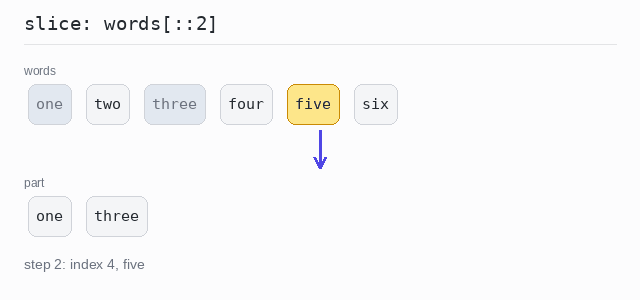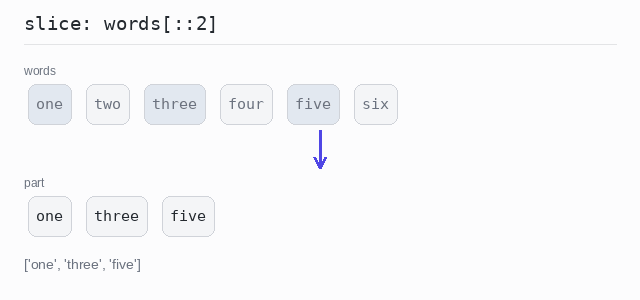
У среза words[::2] не указаны начало и конец, поэтому он охватывает весь список, а шаг 2 берёт каждый второй элемент: индексы 0, 2 и 4. Цикл не нужен — шаг входит в синтаксис среза.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five", "six"]

# третье число среза - это шаг: каждый второй элемент
part = words[::2]

print(part)
Срез по списку индексов
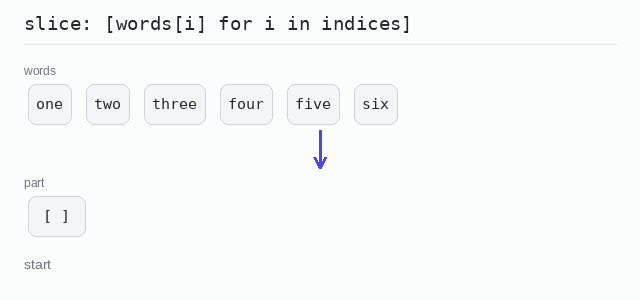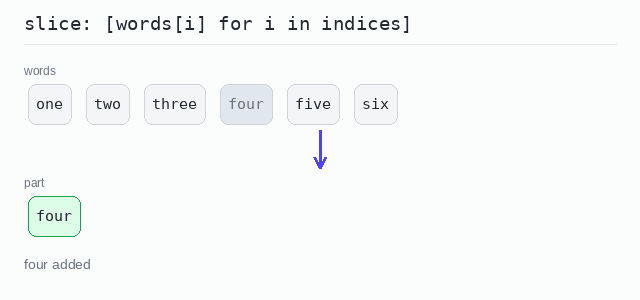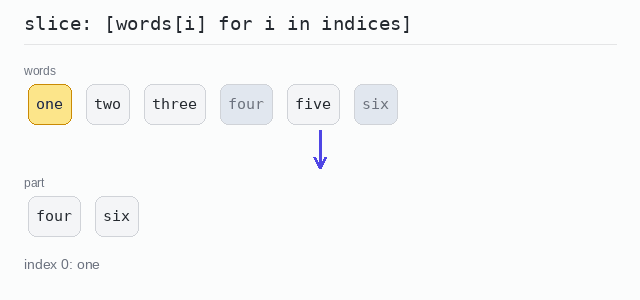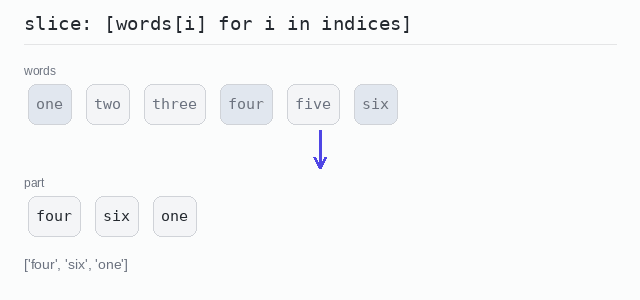
Позиции 3, 5 и 0 хранятся в списке чисел. Генератор списка берёт слово на каждой позиции, поэтому результат идёт в порядке индексов.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five", "six"]
indices = [3, 5, 0]

# берём элементы на заданных позициях в этом порядке
part = [words[i] for i in indices]

print(part)
Take и Drop
Take означает оставить несколько элементов с одного конца. Drop означает отбросить несколько элементов с одного конца и оставить остальные.
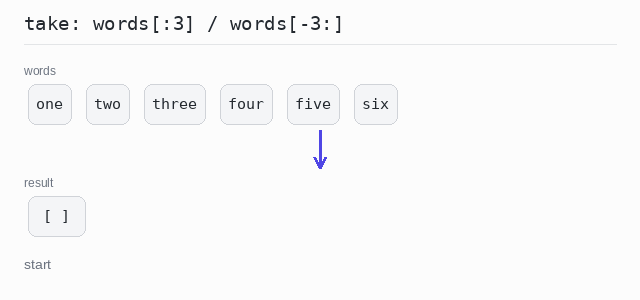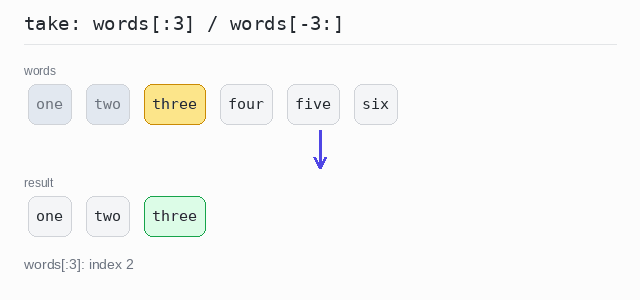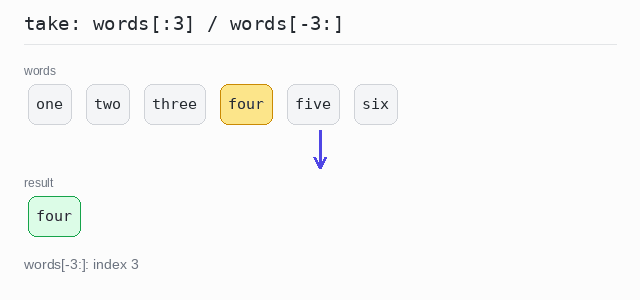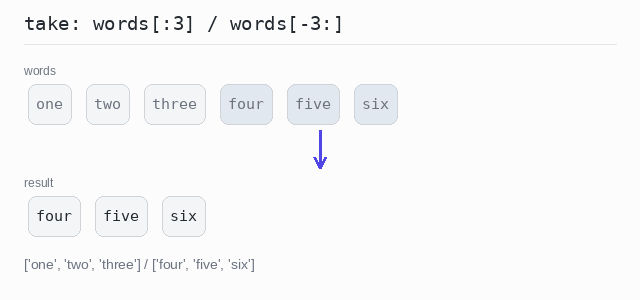
В Python и то и другое — срезы. words[:3] берёт первые 3 элемента, а words[-3:] — последние 3. words[1:] отбрасывает первый элемент, а words[:-5] — последние 5.
Есть и версии с условием. Они не считают элементы: они идут с одного конца и останавливаются на первом элементе, который не выполняет условие. В Python они встроены в модуль itertools: takewhile() оставляет элементы с начала, пока условие выполняется, а dropwhile() пропускает элементы, пока условие выполняется, и оставляет остальные. Обе функции возвращают ленивый итератор, поэтому оберните вызов в list(), чтобы увидеть элементы. Для тех же задач с конца списка встроенной функции нет: запустите функцию на reversed(words) и разверните результат обратно с помощью [::-1].
Взять первые или последние n элементов
words[:3] оставляет первые 3 слова. words[-3:] оставляет последние 3, потому что отрицательный индекс отсчитывается от конца.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five", "six"]

first3 = words[:3]  # первые 3 элемента
last3 = words[-3:]  # последние 3 элемента

print(first3)
print(last3)
Отбросить первые или последние n элементов
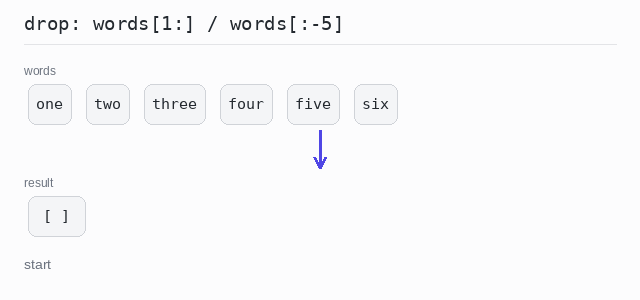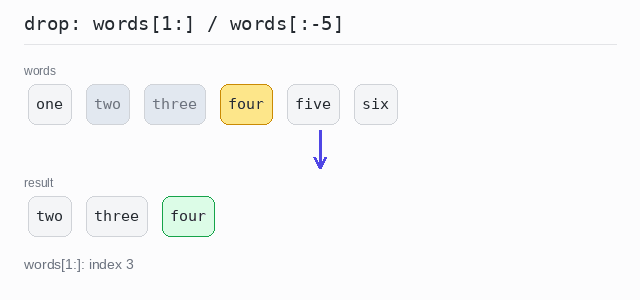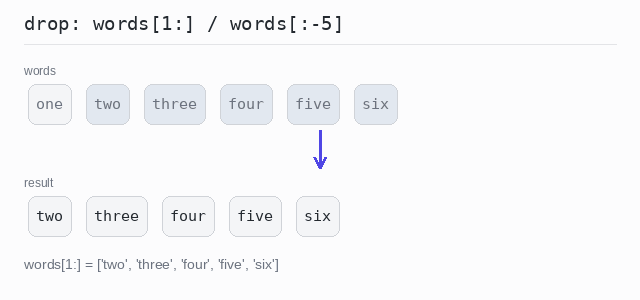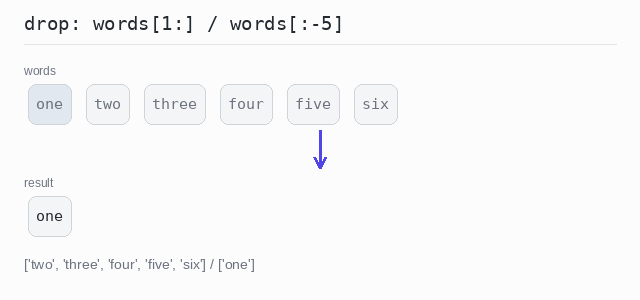
words[1:] пропускает первое слово. words[:-5] пропускает последние 5 слов, поэтому остаётся только one.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five", "six"]

without_first = words[1:]   # отбрасываем первый элемент
without_last5 = words[:-5]  # отбрасываем последние 5 элементов

print(without_first)
print(without_last5)
Брать, пока выполняется условие
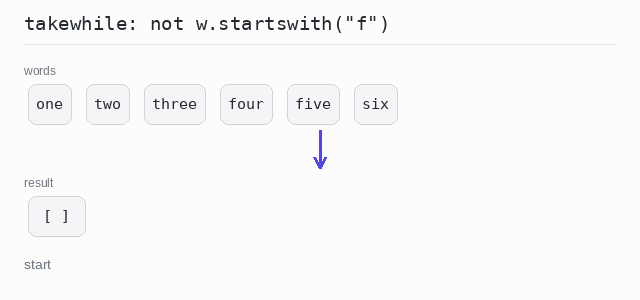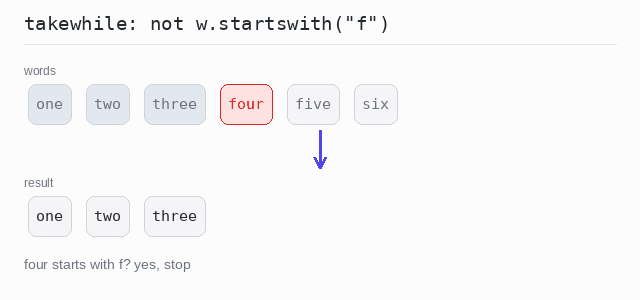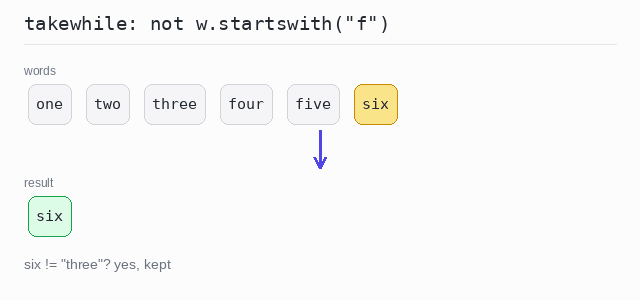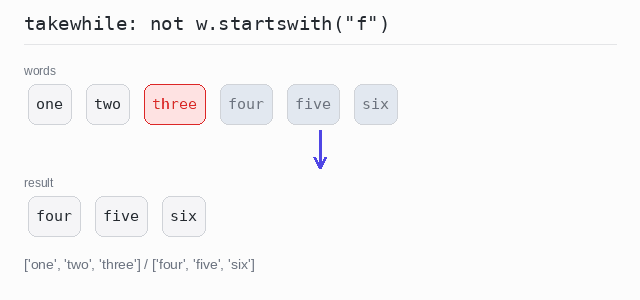
takewhile() оставляет слова с начала, пока не встретит слово, начинающееся с f. Условие — это lambda, небольшая функция без имени, а startswith() проверяет начало строки. Для конца списка takewhile() проходит по reversed(words) — оставляет слова, пока не встретит three, — а [::-1] разворачивает результат обратно.
Вывод: полная программа на Python
from itertools import takewhile

words = ["one", "two", "three", "four", "five", "six"]

# оставляем с начала, пока слово не начинается с "f"
from_start = list(takewhile(lambda w: not w.startswith("f"), words))

# то же с конца: проходим по развёрнутому списку, затем разворачиваем результат обратно
from_end = list(takewhile(lambda w: w != "three", reversed(words)))[::-1]

print(from_start)
print(from_end)
Отбрасывать, пока выполняется условие
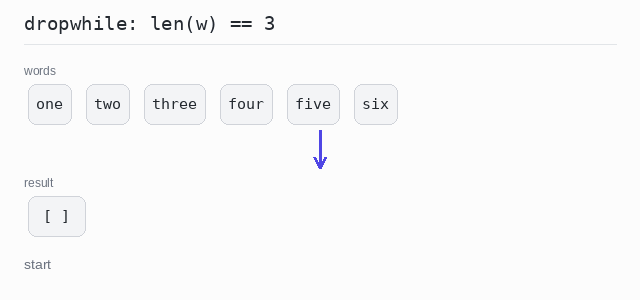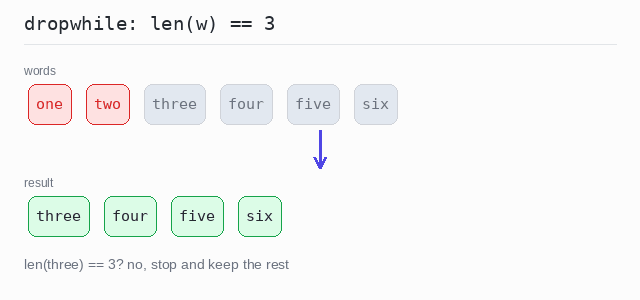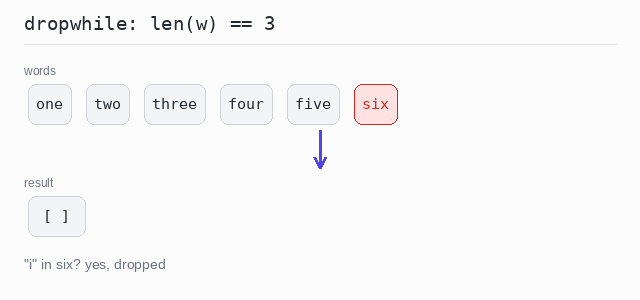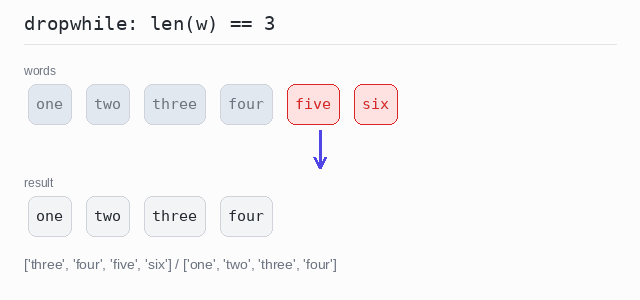
dropwhile() пропускает слова из 3 букв в начале и оставляет всё, начиная с three. Тот же приём с reversed() пропускает слова с конца, пока они содержат букву i. Оператор in проверяет, содержит ли строка фрагмент текста.
Вывод: полная программа на Python
from itertools import dropwhile

words = ["one", "two", "three", "four", "five", "six"]

# пропускаем с начала, пока в слове 3 буквы, остальное оставляем
from_start = list(dropwhile(lambda w: len(w) == 3, words))

# то же с конца: проходим по развёрнутому списку, затем разворачиваем результат обратно
from_end = list(dropwhile(lambda w: "i" in w, reversed(words)))[::-1]

print(from_start)
print(from_end)
Разбиение на части
Разбиение на части означает разрезание списка на куски одинакового размера. Последний кусок может быть короче, если элементы не делятся поровну.
В этой версии Python нет встроенной функции для разбиения на части (в более новых версиях добавлена itertools.batched()), но вспомогательная функция занимает одну строку: range(0, len(items), size) даёт начальные индексы 0, 3, 6, …, а срез вырезает от каждого из них один кусок. Срез никогда не читает за пределами списка, поэтому короткий последний кусок получается правильным сам собой.
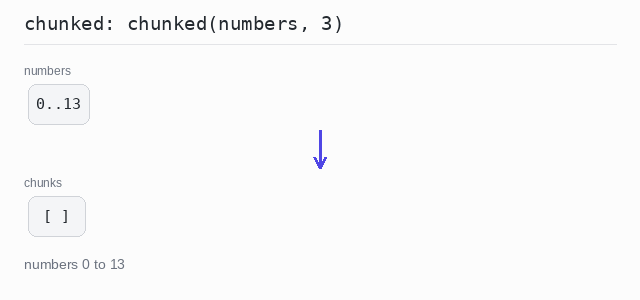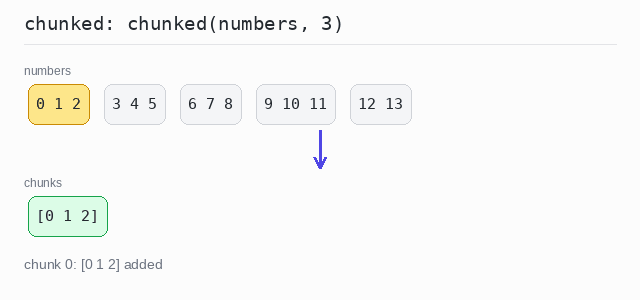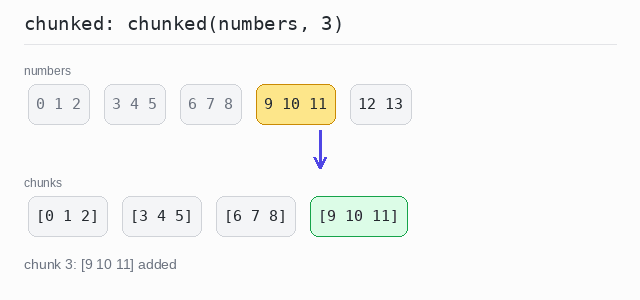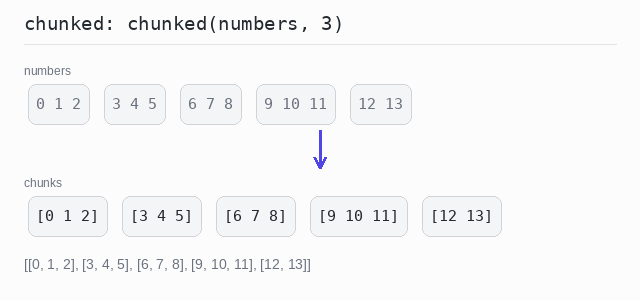
Результат — список списков, и у каждого куска свои скобки: [[0, 1, 2], [3, 4, 5], …].
Чтобы сразу обработать каждый кусок, поместите куски в генератор списка.
Разбить на части по 3
Числа от 0 до 13 разрезаются на куски по 3. В последнем куске только 2 элемента: [12, 13].
Вывод: полная программа на Python
def chunked(items, size):
  # один срез на кусок: начала равны 0, size, 2*size, ...
  return [items[i:i + size] for i in range(0, len(items), size)]

numbers = list(range(14))

chunks = chunked(numbers, 3)

print(chunks)
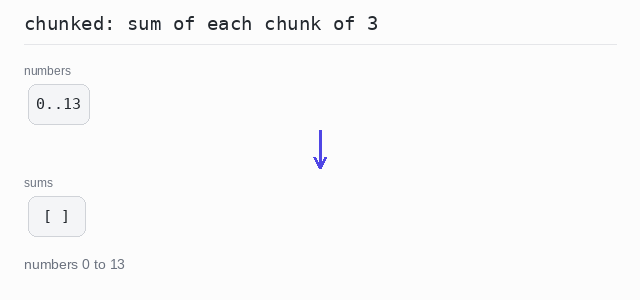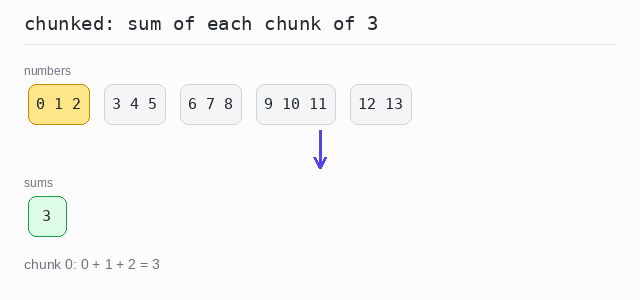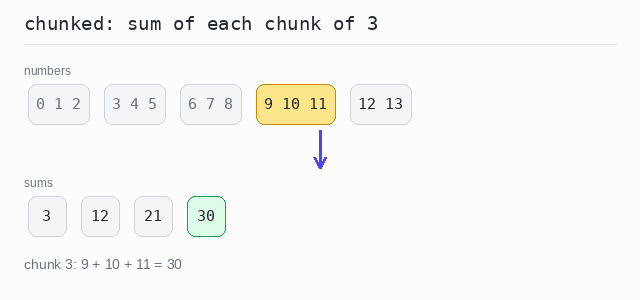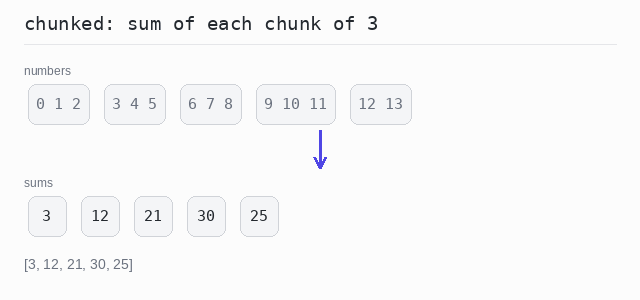
Сумма каждой части
Те же куски, но каждый из них складывается встроенной функцией sum(). Сохраняются только суммы: [3, 12, 21, 30, 25].
Вывод: полная программа на Python
def chunked(items, size):
  return [items[i:i + size] for i in range(0, len(items), size)]

numbers = list(range(14))

# складываем каждый кусок из 3 элементов, сохраняем только суммы
sums = [sum(chunk) for chunk in chunked(numbers, 3)]

print(sums)
Скользящее окно
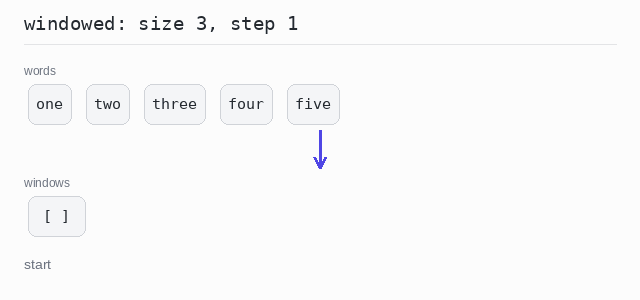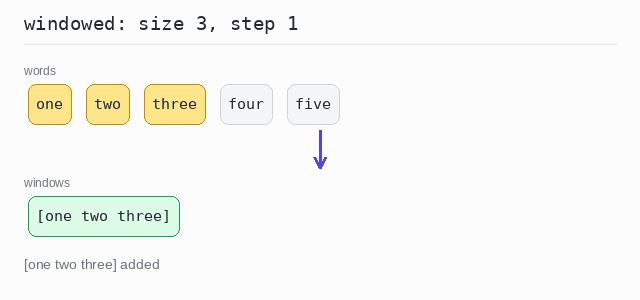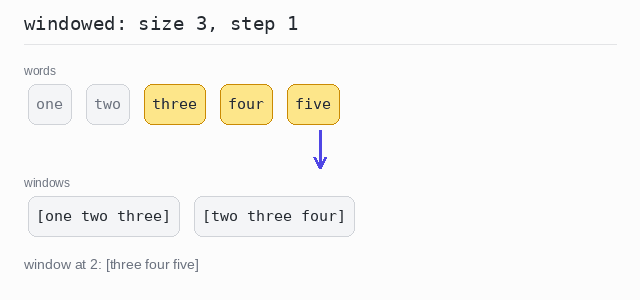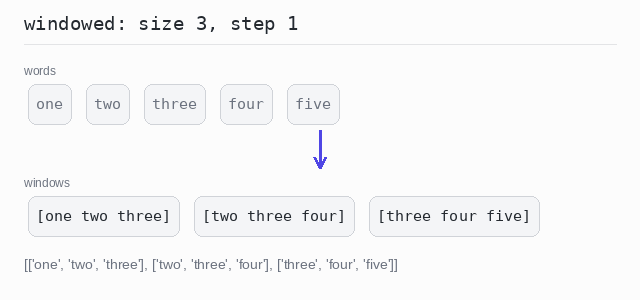
Окно — это группа соседних элементов. Скользящее окно сдвигает эту группу вдоль списка и собирает все её положения. В отличие от кусков, окна перекрываются.
В Python нет встроенной функции windowed. Это делает генератор списка с items[i:i + size], а небольшая вспомогательная функция windowed позволяет использовать его повторно. С параметром step окно сдвигается сразу на несколько позиций. Если partial равен True, более короткое окно в конце сохраняется, а не отбрасывается.
Окно из 2 элементов, которое сдвигается на 1 шаг, — это то же самое, что составить пару из каждого элемента и следующего за ним. В Python для этого есть классическая идиома zip(words, words[1:]), а в модуле itertools есть готовая функция pairwise().
Окна по 3
В окне 3 слова, и каждый раз оно сдвигается на 1 позицию. range(len(items) - size + 1) останавливается, когда полное окно больше не помещается, поэтому окон 3. Результат — список списков, выведенный в одну строку.
Вывод: полная программа на Python
def windowed(items, size):
  # каждая группа из size соседних элементов, сдвиг на одну позицию за раз
  return [items[i:i + size] for i in range(len(items) - size + 1)]

words = ["one", "two", "three", "four", "five"]

print(windowed(words, 3))
Окна с шагом и неполные окна
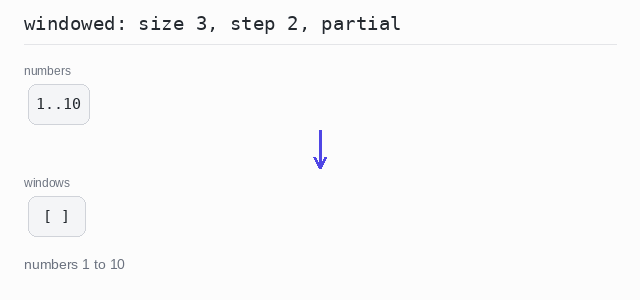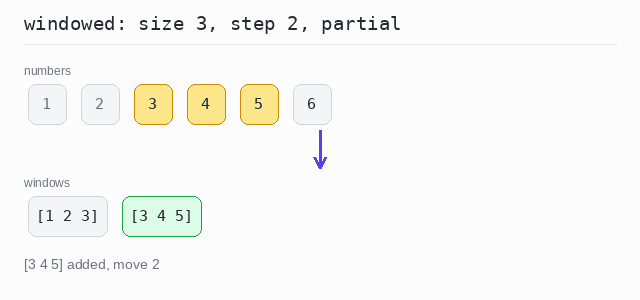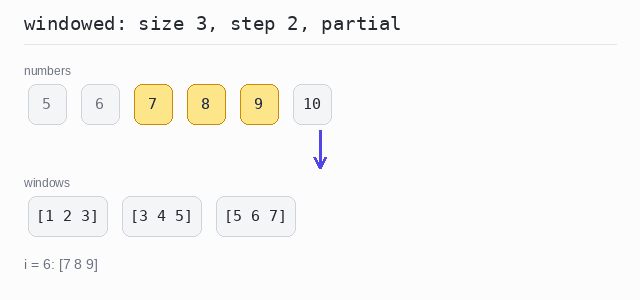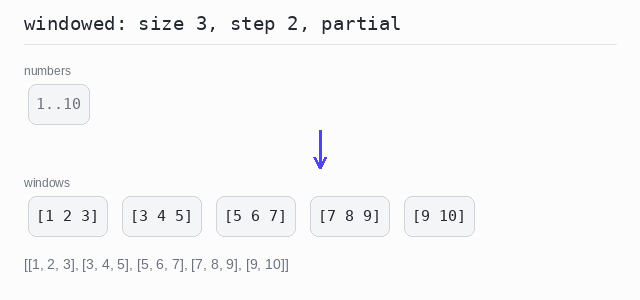
В окне 3 числа, и каждый раз оно сдвигается на 2 позиции. Поскольку partial равен True, последнее окно [9, 10] сохраняется, хотя оно короче.
Вывод: полная программа на Python
def windowed(items, size, step=1, partial=False):
  result = []
  for i in range(0, len(items), step):
    window = items[i:i + size]
    if len(window) < size and not partial:
      break
    result.append(window)
  return result

numbers = list(range(1, 11))

print(windowed(numbers, 3, step=2, partial=True))
Сумма каждого окна
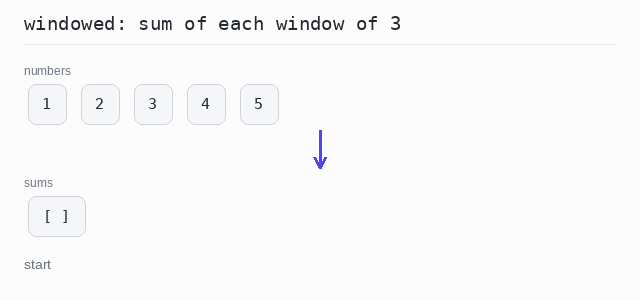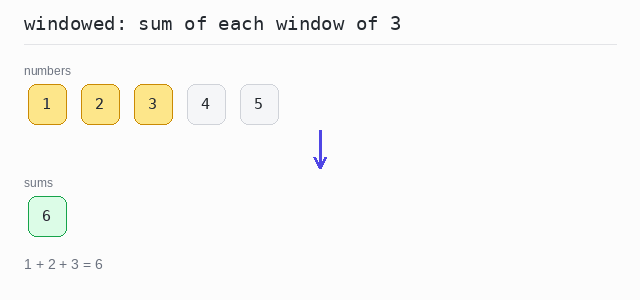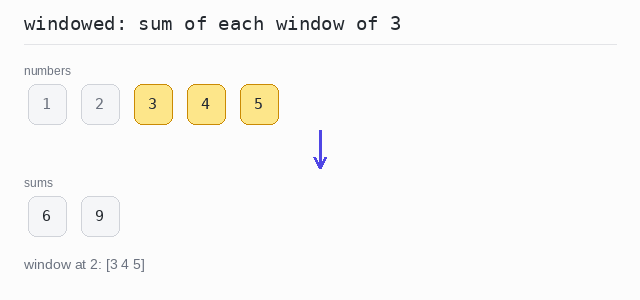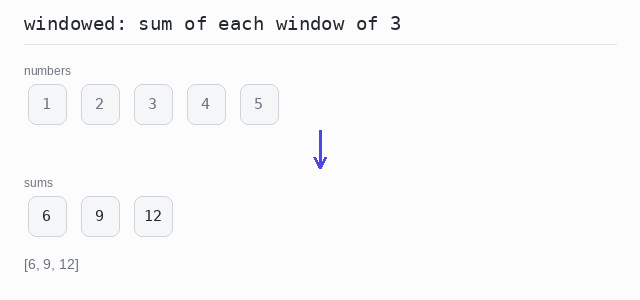
Каждое окно из 3 соседних элементов складывается с помощью sum(). Сохраняются только суммы: [6, 9, 12].
Вывод: полная программа на Python
numbers = [1, 2, 3, 4, 5]

# складываем каждое окно из 3 соседних элементов, сохраняем только суммы
sums = [sum(numbers[i:i + 3]) for i in range(len(numbers) - 2)]

print(sums)
Пара из каждого элемента и следующего
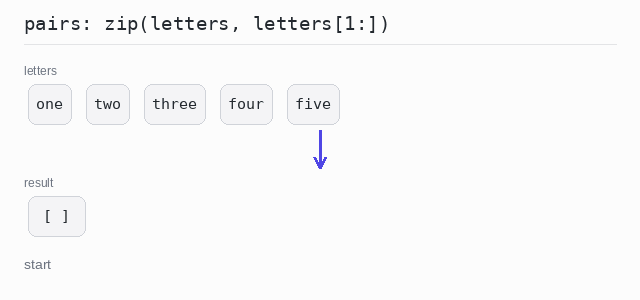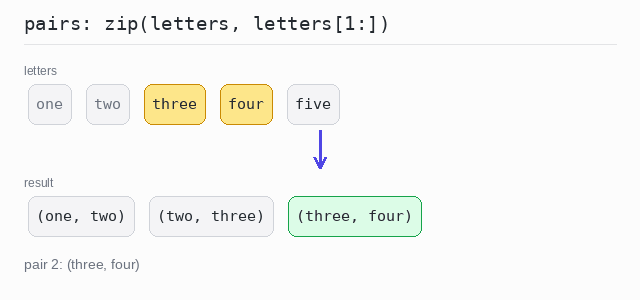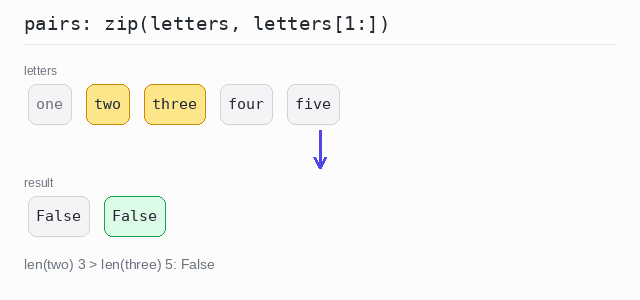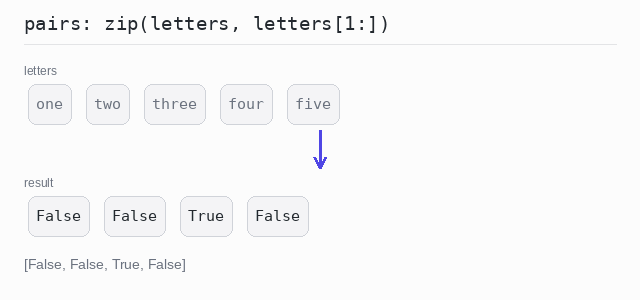
zip(letters, letters[1:]) составляет пару из каждого слова и его соседа. Каждая пара — это кортеж, который выводится в круглых скобках: ('one', 'two'). itertools.pairwise() даёт те же пары в готовом виде; здесь она передаёт их в генератор списка, который записывает, длиннее ли первое слово второго.
Вывод: полная программа на Python
from itertools import pairwise

letters = ["one", "two", "three", "four", "five"]

# каждый элемент вместе со следующим за ним, в виде кортежей
pairs = list(zip(letters, letters[1:]))
print(pairs)

# те же соседние элементы из itertools.pairwise, сравниваем по длине
longer = [len(a) > len(b) for a, b in pairwise(letters)]
print(longer)